KI-Training per robots.txt stoppen: Google, OpenAI und Microsoft planen gemeinsame Regeln
02.11.2026 um 13:27 Uhr, von Anne
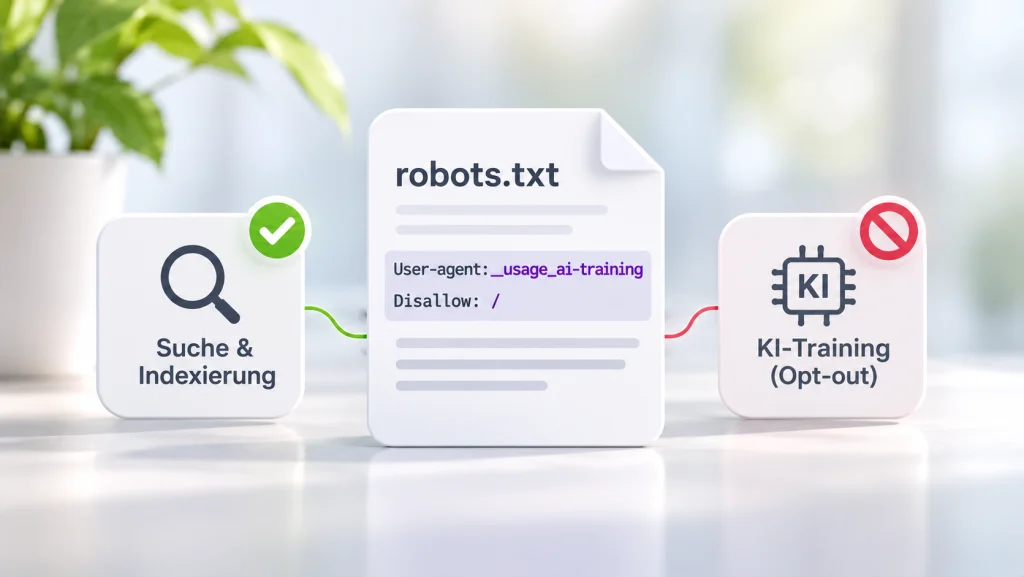
- Google, Microsoft und OpenAI wollen eine gemeinsame robots.txt-Regel für KI-Training unterstützen. Der Vorschlag stammt aus der IETF-Arbeitsgruppe AI Preferences und soll die Verwaltung unterschiedlicher KI-Crawler vereinfachen.
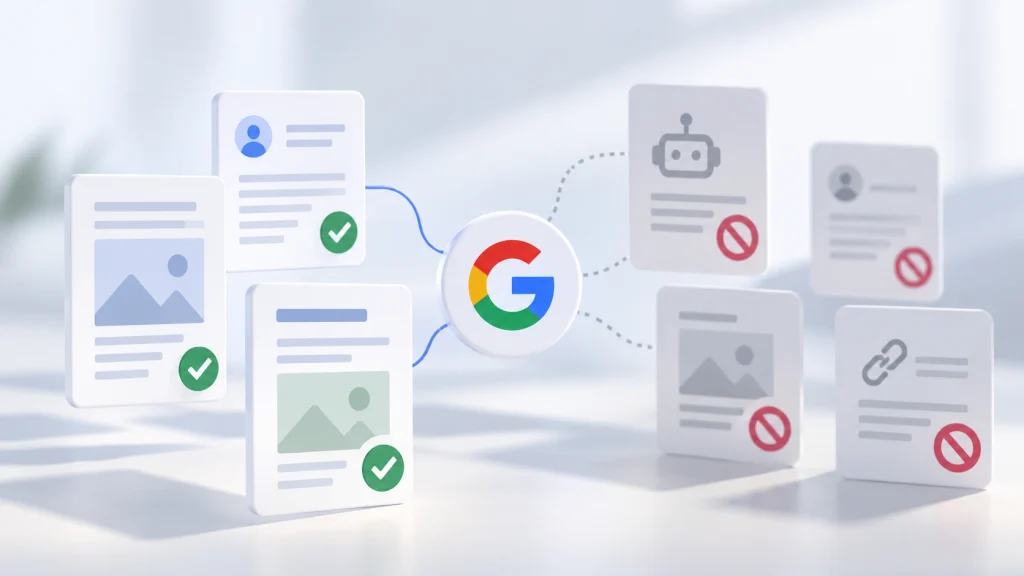
- Die neue Regel steuert die gewünschte Nutzung von Inhalten für das Training generativer KI-Modelle. Sie ist nicht mit einer Sperre für Suchmaschinen-Crawling, Indexierung oder KI-generierte Antworten gleichzusetzen.
- Für Publisher, Unternehmen und Onlinehändler entsteht mehr Kontrolle, aber auch eine strategische Entscheidung: Wer KI-Training einschränken möchte, sollte prüfen, welche Auswirkungen die Einstellungen bei den einzelnen Anbietern auf die Sichtbarkeit haben.
Inhaltsverzeichnis
Websitebetreiber sollen künftig einfacher bestimmen können, ob ihre Inhalte für das Training generativer KI-Modelle verwendet werden dürfen. Google, Microsoft und OpenAI haben am 30. Oktober 2026 angekündigt, eine gemeinsame Steuerungsmöglichkeit über die robots.txt unterstützen zu wollen. Auch Anthropic beteiligt sich an der Entwicklung. Bislang müssen Publisher häufig unterschiedliche Regeln für einzelne KI-Anbieter verwalten. Der neue Ansatz soll das vereinfachen: Eine gemeinsame Anweisung könnte ausreichen, um die Nutzung von Website-Inhalten für das KI-Training bei mehreren teilnehmenden Unternehmen abzulehnen.
Für SEO und Online-Marketing ist die Ankündigung besonders interessant. Denn Unternehmen müssen künftig noch genauer zwischen zwei Zielen unterscheiden: Sie möchten mit ihren Inhalten in Suchmaschinen und KI-Antworten sichtbar bleiben, gleichzeitig aber möglicherweise verhindern, dass diese Inhalte zum Training neuer KI-Modelle verwendet werden.
Was Google, Microsoft, OpenAI und Anthropic angekündigt haben
Die Grundlage der neuen Regel ist ein Entwurf aus dem Umfeld der Internet Engineering Task Force (IETF). Dort beschäftigt sich die Arbeitsgruppe AI Preferences mit technischen Möglichkeiten, Nutzungspräferenzen für KI-Systeme maschinenlesbar auszudrücken. Der am 30. Oktober 2026 veröffentlichte Entwurf wurde von Kevin Kelley von Anthropic verfasst. Er sieht ein gemeinsames Kennzeichen vor, das innerhalb der bestehenden robots.txt verwendet wird. Die Datei ist Websitebetreibern bereits aus der Suchmaschinenoptimierung bekannt. Sie liegt üblicherweise im Hauptverzeichnis einer Domain und enthält Anweisungen für automatisierte Crawler. Neu ist die Möglichkeit, darin eine Präferenz speziell für das Training generativer KI-Modelle zu formulieren.
Die vorgeschlagene Regel lautet:
User-agent: __usage_ai-training
Disallow: /
Damit erklärt ein Websitebetreiber, dass seine Inhalte nicht für das Training generativer KI-Modelle durch teilnehmende Anbieter verwendet werden sollen. Der Entwurf erlaubt auch Ausnahmen für bestimmte Verzeichnisse. Ein Unternehmen könnte beispielsweise das Training für seine gesamte Website ablehnen, einen öffentlich vorgesehenen Pressebereich jedoch freigeben. Wichtig ist, dass es sich bislang um einen Standardisierungsvorschlag und nicht um einen bereits überall umgesetzten Internetstandard handelt.
Die Unternehmen haben unterschiedliche Zeitpläne genannt. Microsoft will die neuen Einstellungen ab dem 1. Februar 2027 berücksichtigen. Google plant die Unterstützung im Jahr 2027, während OpenAI eine Umsetzung in den kommenden Monaten angekündigt hat. Anthropic arbeitet ebenfalls an der Unterstützung des gemeinsamen Signals. Bis zur vollständigen Einführung sollten Websitebetreiber bestehende anbieterspezifische Regeln nicht vorschnell entfernen.
KI-Training verhindern und trotzdem in Google sichtbar bleiben – geht das?
Für SEO-Verantwortliche ist die wichtigste Frage, was die neue Regel tatsächlich bewirkt. Eine Anweisung gegen KI-Training ist nicht dasselbe wie eine Anweisung gegen das Crawling einer Website. Beim KI-Training werden Inhalte verwendet, um die gelernten Parameter eines generativen KI-Modells zu verändern. Beim Crawling ruft ein automatisiertes System Webseiten ab, um Informationen zu erfassen. Bei der Indexierung werden Inhalte für die Auffindbarkeit in einer Suchmaschine verarbeitet.
Und beim sogenannten Grounding können aktuelle externe Informationen genutzt werden, um KI-generierte Antworten zu unterstützen. Diese Vorgänge hängen technisch teilweise zusammen, sind aber nicht identisch. Der neue gemeinsame Token soll ausdrücklich die Trainingspräferenz ausdrücken. Er bedeutet nicht automatisch, dass Googlebot oder Bingbot eine Website nicht mehr besuchen dürfen. Auch eine allgemeine Regel wie User-agent: * gilt nach dem Entwurf nicht als ausdrückliche Präferenz gegen KI-Training. Dafür ist die neue Kennung erforderlich. Allerdings unterscheiden sich die konkreten Umsetzungen der Anbieter. Google kündigt an, ein allgemeines Trainings-Opt-out so zu behandeln, als wäre Google-Extended gesperrt, sofern die Website keine ausdrückliche eigene Regel für Google-Extended enthält.
Das ist wichtig, weil Google-Extended nicht nur für bestimmte Trainingsnutzungen relevant ist, sondern auch mit der Nutzung von Inhalten für das Grounding in Gemini-Anwendungen zusammenhängt. Eine Sperre kann deshalb Folgen für die mögliche Sichtbarkeit in diesen Anwendungen haben. Microsoft verfolgt einen differenzierteren Ansatz. Dort sollen sich KI-Training und die Verwendung von Inhalten zur Unterstützung generierter Antworten getrennt steuern lassen.
Für Websitebetreiber bedeutet das: Eine gemeinsame Trainingsregel vereinfacht die Verwaltung, führt aber nicht automatisch bei allen KI-Anbietern zu denselben Auswirkungen.
Wer in der klassischen Suche und in KI-Antworten sichtbar bleiben möchte, sollte die Einstellungen deshalb sorgfältig aufeinander abstimmen.
Welche Folgen hat der neue Standard für SEO, GEO und Online-Marketing?
Für Publisher und Unternehmen ist die Ankündigung ein wichtiger Schritt, weil sie erstmals eine breiter unterstützte gemeinsame Steuerung der Trainingsnutzung in Aussicht stellt. Bisher mussten Betreiber unterschiedliche Crawler und Anbieter berücksichtigen. Das erschwert die technische Verwaltung, insbesondere bei größeren Websites. Ein gemeinsames Signal könnte diesen Aufwand reduzieren. Gleichzeitig entsteht eine neue strategische Frage: Welche Inhalte sollen für das Training von KI-Modellen zur Verfügung stehen und welche nicht? Für Nachrichtenportale, Fachmedien und andere Publisher kann die Kontrolle über eigene Inhalte wirtschaftlich bedeutsam sein. Sie investieren in Recherche, Fachwissen und redaktionelle Arbeit. Wenn diese Inhalte zum Training kommerzieller KI-Modelle verwendet werden, stellt sich die Frage nach Kontrolle, Lizenzierung und möglicher Vergütung.
Die neue robots.txt-Regel schafft allerdings keinen automatischen Vergütungsanspruch und kein technisches Kopierschutzsystem. Sie ist zunächst ein maschinenlesbares Signal, dessen Beachtung von den jeweiligen Anbietern abhängt.
Auch für Onlinehändler ist die Entwicklung relevant. Produktbeschreibungen, Ratgeber und Kaufberatungen können wertvolle Informationen enthalten. Gleichzeitig möchten Händler mit diesen Inhalten in Google, Bing und KI-gestützten Einkaufssystemen gefunden werden. Eine pauschale Sperre sollte deshalb nicht ohne Prüfung eingerichtet werden. Besonders im Bereich Generative Engine Optimization (GEO) wird die Unterscheidung zwischen Training und aktueller Informationsnutzung wichtiger. Ein Unternehmen kann grundsätzlich das Training mit seinen Inhalten ablehnen und dennoch anstreben, in Suchergebnissen oder KI-Antworten berücksichtigt zu werden.
Ob diese Trennung praktisch möglich ist, hängt jedoch von den Steuerungsmöglichkeiten des jeweiligen Anbieters ab. Für Marketingverantwortliche ergibt sich daraus eine neue Aufgabe: Die technische Verwaltung von KI-Crawlern muss mit den Zielen für Reichweite, Markenbekanntheit und Kundengewinnung abgestimmt werden.
Wer Inhalte schützt, sollte wissen, welche Sichtbarkeit er möglicherweise einschränkt. Wer Inhalte freigibt, sollte verstehen, für welche Zwecke sie genutzt werden können.
Was Websitebetreiber jetzt tun sollten
Für die meisten Unternehmen besteht kein Grund, ihre robots.txt sofort vollständig umzubauen. Der gemeinsame Standard befindet sich noch in der Einführung. estehende Regeln für einzelne Anbieter bleiben zunächst relevant. Sinnvoll ist jedoch eine Bestandsaufnahme. Websitebetreiber sollten prüfen, welche Crawler-Einstellungen bereits vorhanden sind und welche Ziele damit verfolgt werden. Besonders wichtig ist die Frage, ob eine Website lediglich in klassischen Suchmaschinen sichtbar sein soll oder auch in KI-gestützten Antworten und Anwendungen. Anschließend lässt sich entscheiden, ob und für welche Bereiche eine Einschränkung der Trainingsnutzung sinnvoll ist. Bei Google müssen vorhandene Google-Extended-Regeln berücksichtigt werden, weil ausdrückliche Einstellungen für diesen Anbieter Vorrang vor dem allgemeinen Signal haben sollen. Bei Microsoft ist außerdem die Umstellung bisheriger Angaben zu beachten. Microsoft kündigt an, NoArchive und NoCache ab dem 1. März 2027 nicht mehr als Signale für KI-Training und Grounding zu verwenden. Betreiber, die diese Angaben bisher zu diesem Zweck einsetzen, sollten rechtzeitig auf die neuen Möglichkeiten umstellen.
Für WordPress-Websites ist wichtig, dass die robots.txt je nach Hosting und Konfiguration als tatsächliche Datei oder dynamisch bereitgestellt werden kann.
Änderungen sollten deshalb nicht ungeprüft vorgenommen werden. Eine fehlerhafte robots.txt-Konfiguration kann unerwünschte Auswirkungen auf das Crawling wichtiger Seiten haben. Unternehmen sollten ihre Einstellungen dokumentieren und nach Änderungen kontrollieren, ob Suchmaschinen weiterhin auf die gewünschten Inhalte zugreifen können.
Mein Fazit
Die geplante gemeinsame robots.txt-Regel ist ein wichtiger Schritt zu mehr Kontrolle über die Nutzung von Website-Inhalten für das KI-Training. Sie löst jedoch nicht sämtliche Fragen rund um KI-Crawler, Urheberrechte und Sichtbarkeit. Vor allem ersetzt sie keine individuelle Strategie für SEO und GEO. Für Websitebetreiber wird künftig entscheidend sein, zwischen der Nutzung ihrer Inhalte zum Modelltraining und der gewünschten Präsenz in Suchmaschinen und KI-Antworten zu unterscheiden. Die beste Lösung ist deshalb nicht zwangsläufig eine vollständige Sperre oder uneingeschränkte Freigabe, sondern eine bewusste Entscheidung auf Grundlage der eigenen Inhalte und Geschäftsziele.
Quellen: